阿里云日志服务 SLS 全新升级,打造 Agent 时代的智能数据引擎
文章目录
在 2026 云栖大会上,阿里云日志服务 SLS 宣布全新升级。在持续夯实的实时数据底座之上,SLS 本次全新发布三大 Agent 原生能力,即面向 Agent 运行数据对象的 SLS SessionStore、面向业务上下文的 SLS 语义层,以及面向 Agent 原生接口的 SLS MCP Server 与可编排 Skills 体系;同时推出面向业务人员的对话式智能体 SLS DataAgent。SLS 在服务开发、运维与业务人员的基础上,进一步面向 Agent 提供实时数据、业务上下文与标准化工具能力,升级为同时服务人与 Agent 的智能数据引擎。
Agent 进入生产系统,SLS 在实时底座之上构建 Agent 原生能力
#
随着 Agent 逐步进入生产系统,应用与数据的关系正在改变。在传统应用中,用户是人与确定性程序,通过控制台或 API 操作,行为是固定流程与可预测结果,数据形态是单行的 Log、Metric 与 Trace Span。在 Agent 应用中,用户变成 Agent,它持续读取数据并调用工具,行为是多步骤的决策与执行,数据形态扩展为 Session 与 Trajectory。Agent 既是数据的新用户,也是新的数据生产者,在使用数据的同时产生运行事实。Agent 数据的价值也从调用记录演变为理解任务。数据范围从一次调用的 Request,扩展到跨多轮、跨模型、跨工具的 Session 与 Trajectory,还原一次完整任务的执行过程;理解深度从字段、状态码、响应结果等技术事件,扩展到业务对象、关系与规则口径,以及任务目标、过程状态与判断证据。
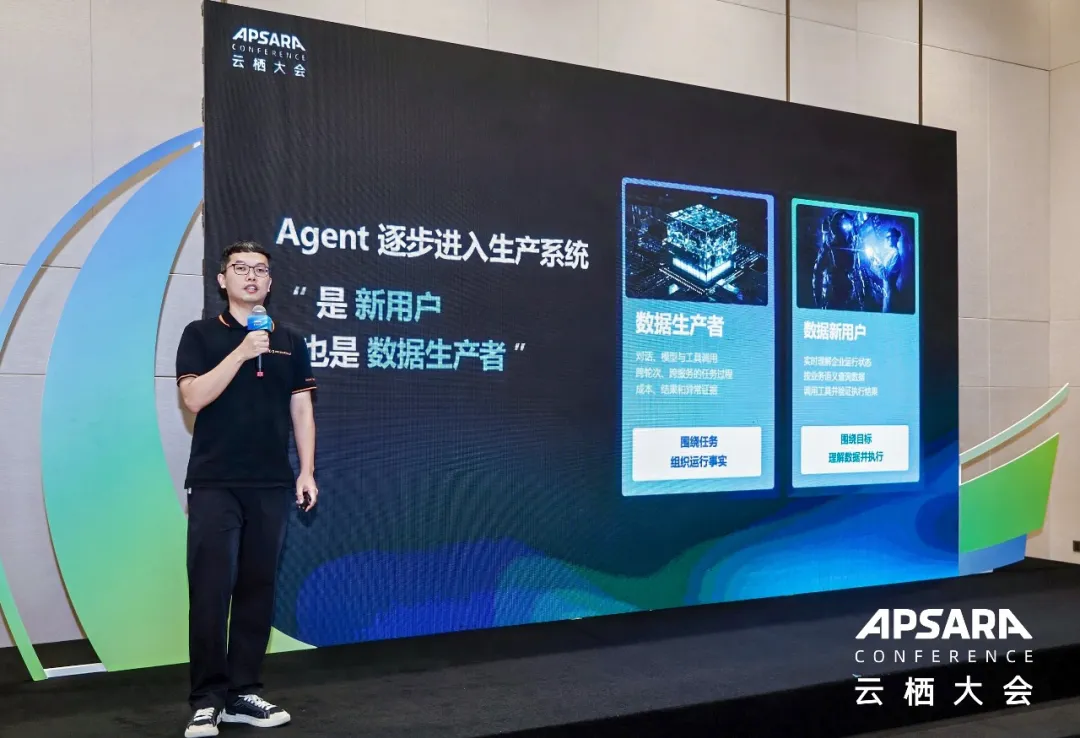
面向 Agent 时代,一个智能数据引擎需要具备四个核心特性,即高效实时、Agent 数据对象、业务语义上下文与 Agent 原生接口。围绕这四个特性,SLS 持续升级实时数据底座,覆盖实时接入、统一存储与索引、实时分析与计算、实时处理四个环节,具备实时、统一、可关联、可验证的特性,统一承载日志、指标、链路、事件等通用观测数据,Message、Tool Call、Step 等 Agent 运行数据,以及用户、订单、资产等业务数据。与此同时,全新发布的 Agent 原生能力,让 SLS 更好地为 Agent 供给可信、可理解的数据,新发布面向会话级数据组织的 SLS SessionStore 与面向业务语义的 SLS 语义层,并推出面向业务分析的 SLS DataAgent;并且让 Agent 更便捷、更安全地使用 SLS,新发布 SLS MCP Server 与可编排的 Skills 体系。
SLS SessionStore:将分散的 Agent 运行记录组织为可复用的会话事实资产
#
要让 SLS 为 Agent 供给可信数据,首先要把 Agent 的运行过程组织好。在此之前,Agent 的推理、模型调用与工具调用散落在 Trace 与日志之中,字段不统一、事件难配对,一次完整任务难以还原,更难被评估与复用。本次全新发布的 SLS SessionStore 面向会话级组织 Agent 数据,Agent 的原始过程数据进入后,系统自动完成字段归一、事件配对与任务过程还原,将其沉淀为可复用的 Session 事实资产。
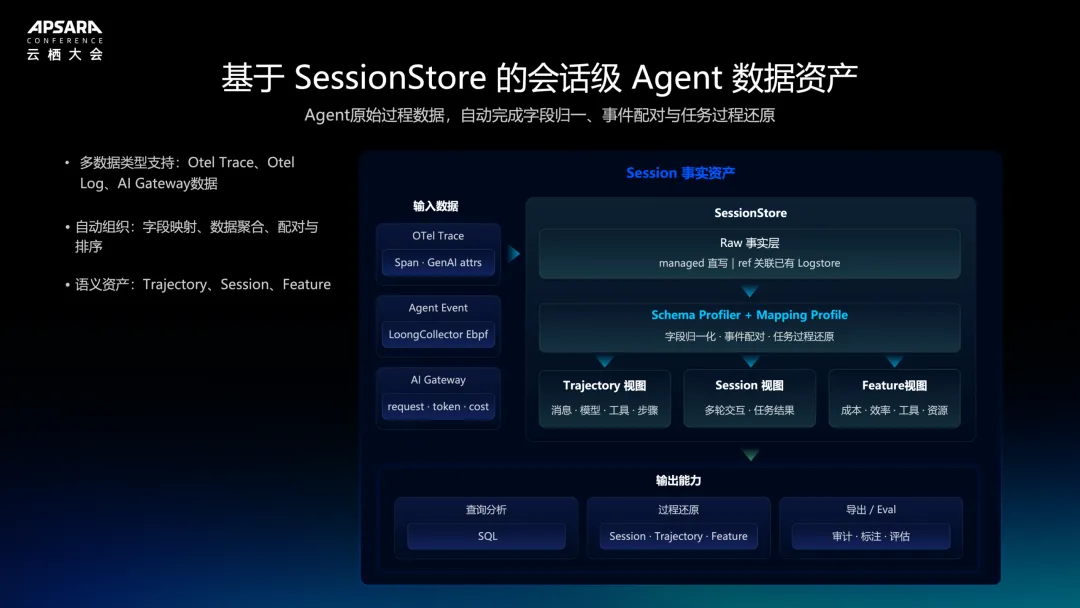
在数据组织上,SessionStore 底层是 Raw 事实层,支持 Managed 直写与 Ref 关联已有 Logstore 两种方式;中间通过 Schema Profiler 与 Mapping Profile 完成字段归一化、事件配对与任务过程还原;上层输出三种语义视图,即还原消息、模型、工具与步骤的 Trajectory 视图,呈现多轮交互与任务结果的 Session 视图,以及刻画成本、效率、工具与资源的特征视图。SessionStore 支持 OTel Trace、OTel Log 与 LLM Gateway Log 等多种数据类型,自动完成字段映射、配对与排序,并通过 SQL 对 Session、Trajectory 与 Raw 数据做查询分析与过程还原,支撑观测、审计、标注与评估等场景。相比企业自行从原始 Trace 加工会话数据,SessionStore 的优势在于零改造与自动化,已有 Logstore 通过 Ref 关联即可纳入、无需迁移,字段归一与事件配对自动完成,一次组织即可同时支撑排障、评估与成本分析等多类视图。
确保 Agent 的每一次运行都被还原为可回看、可评估、可复用的数据资产,为下游的观测分析、质量评估与持续优化提供可直接消费的输入,而不必每次都从原始 Trace 里重新拼接一次任务。
SLS 语义层:让 Agent 读懂数据背后的业务
#
数据组织好之后,还要让 Agent 读懂其中的业务含义。通用 Agent 能读出字段与数值,却读不懂这些字段在特定业务里代表什么、指标该用哪种口径计算、异常阈值定在哪里,回答因此容易答偏,口径也容易各处不一致。本次全新发布的 SLS 语义层正是补齐这一层能力,它从运行数据中自动提取事实模型,按业务域组织统一语义,形成 SLS 数据资产、事实模型、业务模型到 Agent 准确回答的完整路径。
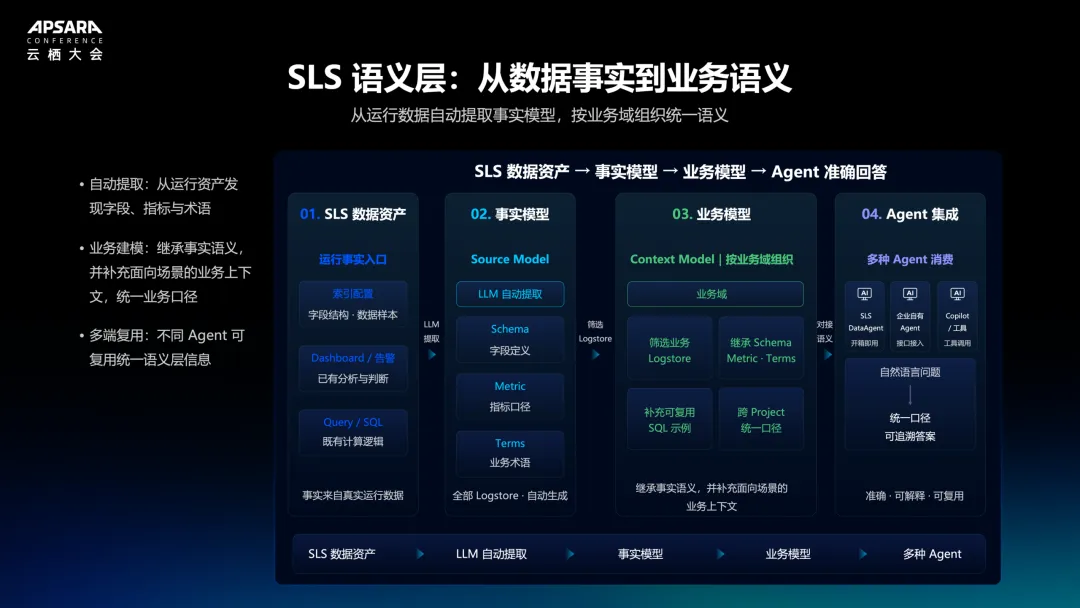
这一路径分为四步。其一,运行事实入口,从 SLS 数据资产中自动发现字段、指标与术语,数据资产涵盖索引配置、Dashboard 与告警、Scheduled SQL 等既有分析资产。其二,事实模型,由 LLM 自动提取全部 Logstore 的 Schema(字段定义)、Metric(指标口径)与 Terms(业务术语)。其三,业务模型,即 Context Model,按业务域框选 Logstore,继承事实语义并补充面向场景的业务上下文,统一跨 Project 的业务口径。其四,Agent 集成,SLS DataAgent 开箱即用,企业自有 Agent 通过接口接入,Copilot 与工具通过工具调用消费。语义层的优势在于自动与可复用,事实模型由 LLM 从真实运行数据中自动提取,不必人工逐个定义,业务模型继承事实语义再补充场景上下文,一次建模即可被多种 Agent 共同消费。
企业不必为每个 Agent 各自维护一套业务口径,同一个问题在 DataAgent、自有 Agent 与第三方工具处都能得到一致、可解释、可追溯的准确回答。
SLS DataAgent:让自然语言问题直达可核对的业务结论
#
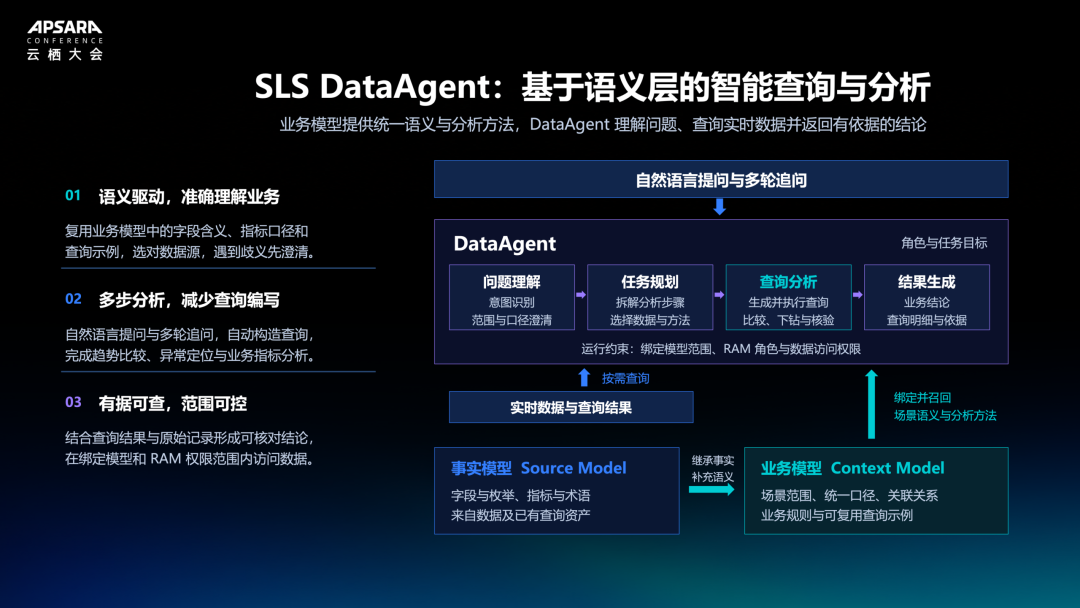
在语义层之上,本次一并推出的 SLS DataAgent,把 SLS 的供给能力直接转化为面向业务人员的分析结论。它是面向业务人员的对话式数据查询与分析能力,建立在 SLS 实时运行数据之上,由 ContextModel 支撑,在企业治理体系内运行,将自然语言问题转化为查询计划、分析结果与可核对的结论。
DataAgent 的差异化在于数据原生。通用 Agent 具备强大的推理力,但面对企业运行数据时,往往无法独立判断字段在特定业务里代表什么、指标该用哪种口径计算、服务与资源与业务如何关联、什么数值才算异常。缺的不是模型,而是上下文。DataAgent 生长在数据发生的地方,把持续变化的运行数据变成可理解、可信任的实时上下文。
以一个游戏客服场景为例。当玩家提问“充值为什么没到账”,若 Agent 直接查询原始日志,面对的是 pay_status=success、deliver_status=failed、error_code=BAG_FULL、item_id=WPN_LEG_001 等碎片字段,跨 Logstore 关联复杂、业务口径不统一,只能给出可能是发货失败、但原因与是否可补发均不确定的回答。而 DataAgent 通过 SLS 语义层查询,语义层已将 BAG_FULL 翻译为背包已满、WPN_LEG_001 翻译为裂天刃,最终给出有证据的业务结论,即支付已成功,因背包已满导致发货失败,清理背包后可按规则重试发货。SLS 语义层在真实数据与 Agent 之间补上业务翻译,让字段值变成可解释的业务结论。
在能力结构上,DataAgent 由三层支撑。感知底座扎根 SLS 实时运行数据,覆盖 Log、Metric、Trace、事件、告警与资源状态;理解中枢绑定 ContextModel,读懂实体、指标口径、关系、异常与已验证的分析路径;行动运行时在治理内执行任务,支持多源触发、动态装配上下文、调用工具与分级审计。行动分三个等级,即只提供分析与建议、经人工确认后执行,以及在明确规则与权限下自动执行。ContextModel 并非一次性生成的静态模型,用户的确认、纠正、新 Query 与处置经验会持续汇入 Context Evidence,经验证与治理后增量更新模型,使 DataAgent 越用越准。在业务场景中,绑定相应 ContextModel 的 DataAgent 可持续输出业务进展、趋势解释、机会点与风险提示,并作为共享能力被营销 Agent、运营 Copilot 与业务工作流复用。
生态协同:AgentLoop 与 STAROps 构建在 SLS 之上
#
SLS 的实时数据底座与全新发布的 Agent 原生能力,也支撑着上层的智能体应用。AgentLoop 基于 SLS 构建企业 Agent 质量评估调优闭环,通过采集探针或 OpenTelemetry 接入 Agent 运行日志与 Trace,由 SLS 承担实时存储、数据加工与查询分析,并基于 SessionStore 组织 Session 与推理轨迹,持续沉淀可复用的运行数据资产,形成观测、评估、实验与持续优化的闭环,覆盖 Coding、运维、客服、游戏等多类 Agentic 应用。
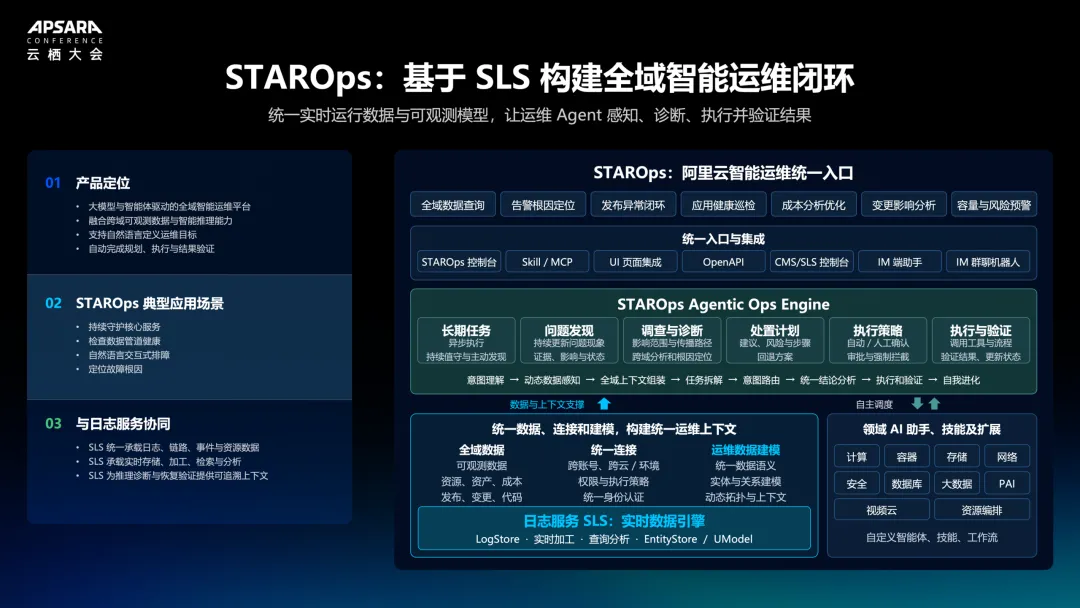
STAROps 基于 SLS 构建全域智能运维闭环。SLS 提供 STAROps 所需的实时运行数据与查询分析能力,统一承载日志、链路、事件与变更,完成实时存储、加工与检索;UModel 在此基础上组织实体、关系拓扑与数据关联,为推理诊断与恢复验证提供可追溯上下文,支持自然语言查数、告警根因分析、变更影响分析与跨产品故障定位。
对上层应用而言,SLS 提供了现成的实时数据与查询分析能力,AgentLoop 与 STAROps 无需各自搭建数据链路,即可把精力集中在评估与运维逻辑本身,这也正是同一套底座能同时支撑质量闭环与运维闭环的原因。
SLS MCP Server 与 Skills 体系:全新发布,让 Agent 更好地使用日志服务
#
除了向上支撑 Agentic 应用,SLS 也将自身能力以标准协议开放给更广泛的 Agent。过去 Agent 调用日志服务,需要自行封装 OpenAPI、管理 AccessKey,还要处理地域与权限,接入门槛高,密钥泄露风险也大。本次全新发布的 SLS MCP Server 让 Agent 通过标准协议、以 OAuth 免密方式安全使用日志服务。它基于 OAuth 登录,在本地运行 Proxy,以 OAuth 凭证代为调用 SLS OpenAPI,并基于 RAM 控制权限,无需填写 AccessKey,敏感配置自动脱敏,访问时自动匹配 Region、免地域限制。MCP Server 提供资源发现、日志分析、告警诊断三大类标准能力,相比自行封装 OpenAPI,MCP Server 的优势在于安全与免改造,以 OAuth 代调用、RAM 控权、敏感配置脱敏,任意支持 MCP 的 Agent 都无需管理密钥、无需改造接入逻辑,即可在权限边界内安全调用日志服务。对开发者而言,过去繁琐的对接工作由此收敛为一次标准协议连接。
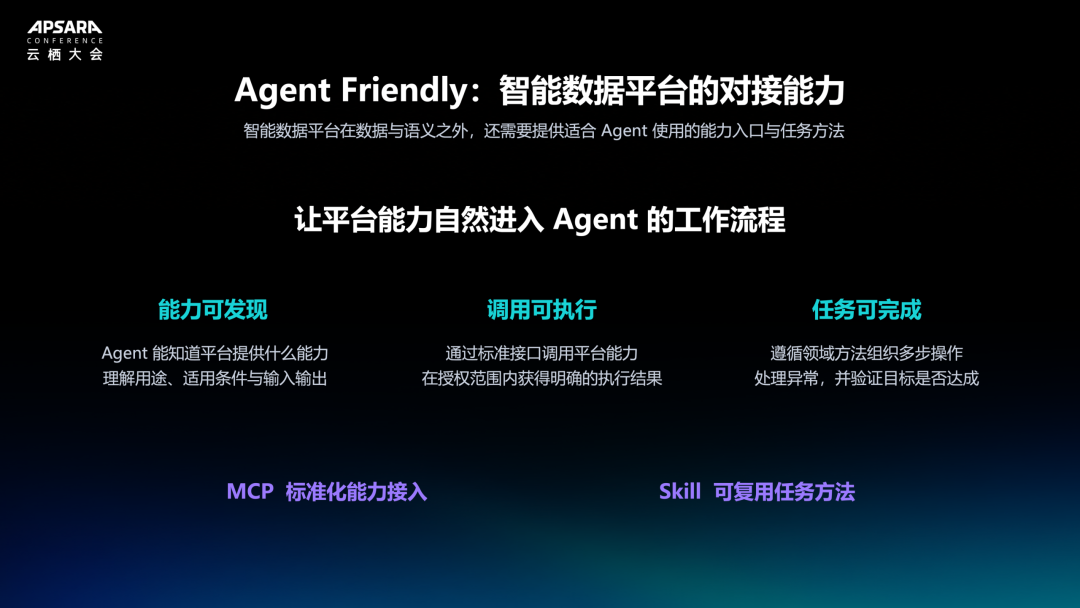
在 MCP 之上,SLS 同步发布可编排的 Skills 体系。一个编排 Skill(alibabacloud-sls-agent-workflow)作为入口,负责意图识别、流程编排、安全门禁与证据收口,串联多个专业 Skill 分域执行,包括 LoongCollector 采集运维、索引配置管理、查询分析、智能分析与 SDK 指导。相比让 Agent 自行摸索每一个操作,Skills 体系的优势在于把专家经验固化为可编排的标准流程。用户以自然语言描述目标,编排 Skill 持续拆解任务,各专业 Skill 分域执行并返回状态、证据与资源结果,最终把用户目标转化为可执行、可确认、可验证的完整任务。
结语
#
从持续升级的实时数据底座,到本次全新发布的 Agent 原生能力,日志服务 SLS 完成了面向 Agent 时代的一次关键升级。一方面,新发布的 SessionStore 让 Agent 运行数据可组织、可还原,新发布的语义层让数据事实可被业务理解,新推出的 DataAgent 让业务人员用自然语言直达可核对的结论;另一方面,新发布的 MCP Server 与 Skills 体系让 Agent 通过标准协议安全调用 SLS。AgentLoop 与 STAROps 等智能体应用则构建在同一套底座之上。当每一份运行数据都有一个懂它的智能体,企业构建 AI Native 数据底座就有了实时、统一、可关联、可验证的基础。
原文来自 阿里云云原生,版权归原作者。
正文采集于 ,内容更新以原文为准。